段选择子只回答"去哪一格找",真正定义一个段的是描述符表里那 8 个字节。这 8 个字节里塞了 32 位段基址、20 位段界限、8 位访问属性和 4 位标志位——加起来正好 64 位,一个 bit 都不剩。
本文把这 8 字节完整拆开:每个字段占哪几位、什么含义、错了会触发哪个异常,以及为什么 Base 和 Limit 在手册图上是碎的。所有结论都标注 Intel SDM 的章节号和印刷页码,最后用 WinDbg 在真机上把 DS = 0023h 一路走到 GDT 里那条 00cff300 0000ffff,逐位读成人话。
本文可以独立阅读,需要的前置只有两个:知道保护模式下地址由"段选择子 + 偏移"构成,以及会用 WinDbg 敲几条只读命令。
一个逻辑地址由 16 位段选择子和一个偏移组成。这两部分的分工是严格切开的:
| 对象 | 回答的问题 | 存在哪里 |
|---|---|---|
| 段选择子 | 查哪张表(GDT 还是 LDT)?表里第几项?请求特权级是多少? | 段寄存器的可见部分 |
| 段描述符 | 这个段从哪开始?多大?是什么类型?谁有资格访问? | GDT / LDT 中的一个 8 字节表项 |
软件把选择子装进段寄存器时,处理器并不是只存那 16 位数字。它会按选择子里的 Index 找到描述符,做一整套合法性检查,再把解出来的基址、界限和属性写进段寄存器的隐藏部分(descriptor cache)。之后参与寻址和权限检查的,是这份缓存。
这里有个做实验时最容易踩的坑:你在内存里改了 GDT 的某 8 字节,当前段寄存器不会自动更新。隐藏缓存要等下一次装载选择子才会重新填。所以属性探测实验里通常要再
mov ds, ax一次。
选择子里的 Index 有 13 位,最多能寻址 8192(2¹³)个表项;描述符表的容量上限也正好是 8192 个 8 字节表项。(IA-32e 模式下的同一上限见 Vol. 3A §3.5.2,印刷页 3-16)
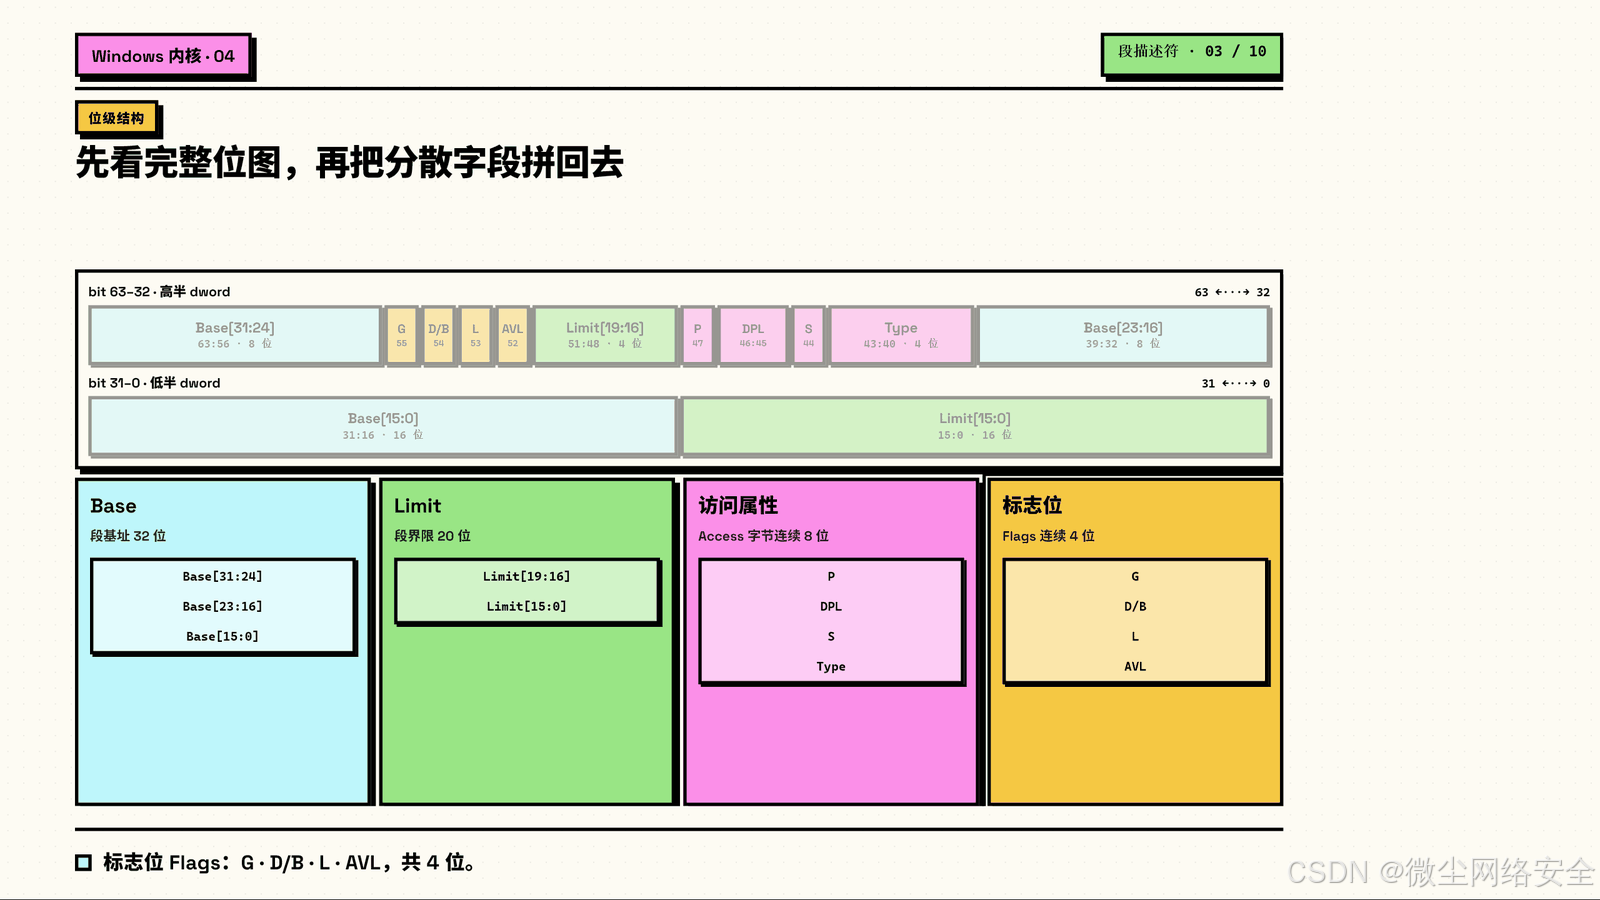
图 1:同一条 8 字节描述符按位切开的样子。青色是段基址(三段)、绿色是段界限(两段)、粉色是访问属性字节、黄色是标志位。四堆加起来 64 位。
先把位号钉死。下表是全文的坐标系,后面每一段都在这张表上作业:
| 字段 | 描述符位号 | 位宽 | 一句话含义 |
|---|---|---|---|
Limit[15:0] | 15:0 | 16 | 段界限低 16 位 |
Base[15:0] | 31:16 | 16 | 段基址低 16 位 |
Base[23:16] | 39:32 | 8 | 段基址中 8 位 |
Type | 43:40 | 4 | 段类型,解码方式由 S 决定 |
S | 44 | 1 | 0 = 系统段,1 = 代码段或数据段 |
DPL | 46:45 | 2 | 描述符特权级,0 最高 |
P | 47 | 1 | 段存在位 |
Limit[19:16] | 51:48 | 4 | 段界限高 4 位 |
AVL | 52 | 1 | 系统软件可用位,硬件不检查 |
L | 53 | 1 | 64 位代码段标志(仅 IA-32e 模式) |
D/B | 54 | 1 | 默认操作数大小 / 栈指针宽度 / 上界 |
G | 55 | 1 | 粒度,决定界限按字节还是按 4 KB 计 |
Base[31:24] | 63:56 | 8 | 段基址高 8 位 |
手册里习惯把 8 字节说成"两个双字"(doubleword)。第二个双字的 bit n,对应本表的描述符 bit n+32。之后引用手册原文时会看到"第二个双字的 bit 21"这种说法,指的就是这里的 bit 53。
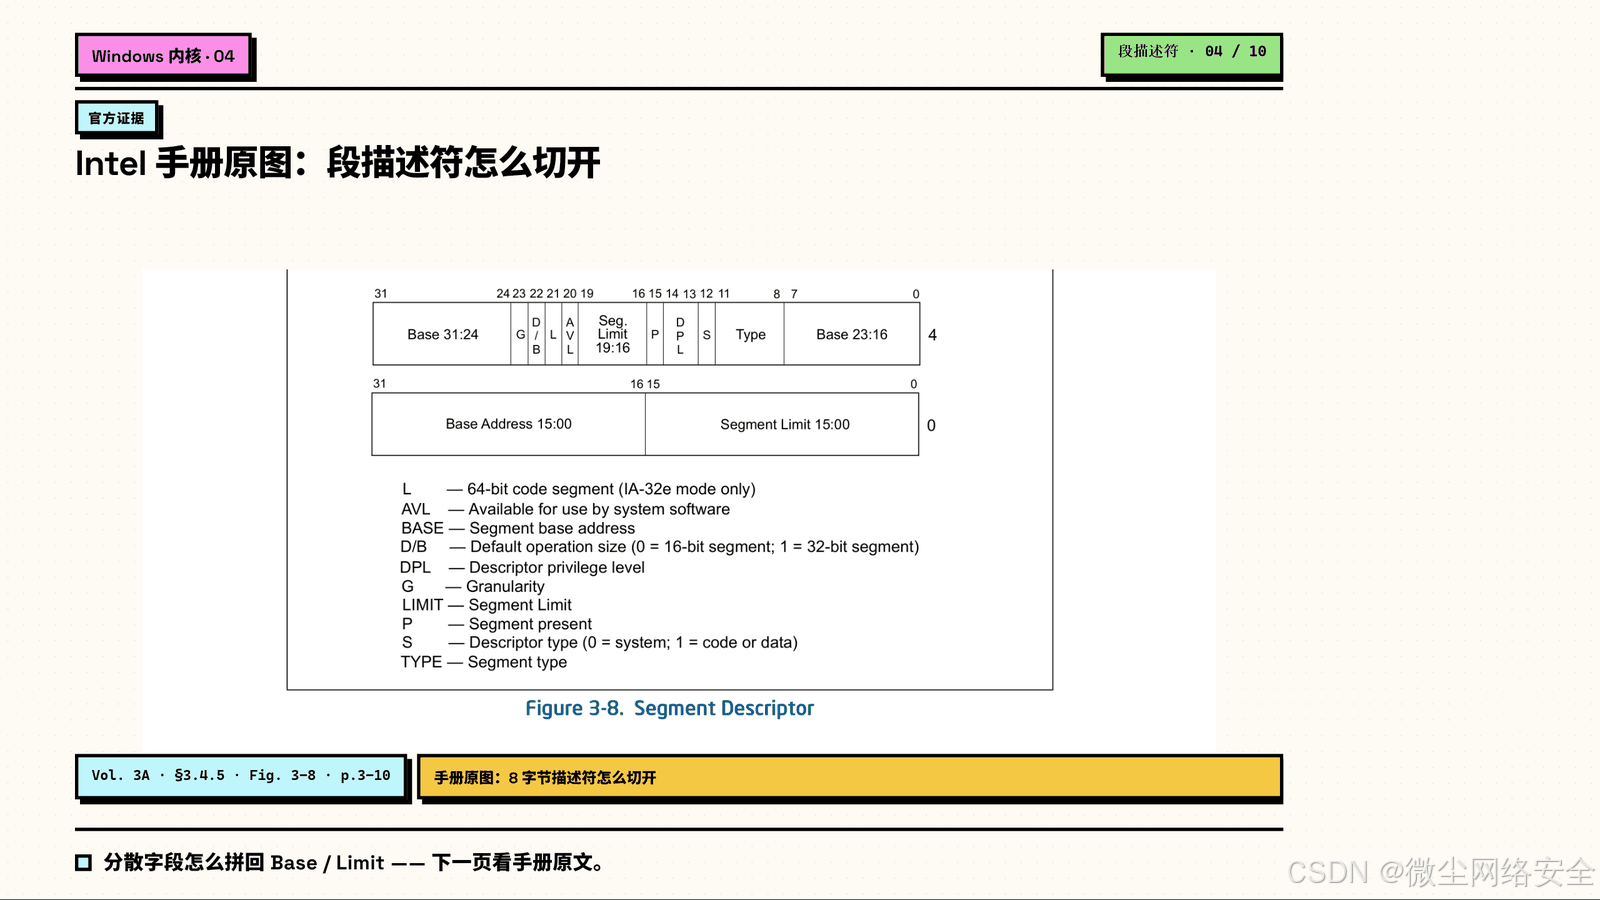
图 2:Intel SDM Vol. 3A §3.4.5 的 Figure 3-8(印刷页 3-10)。上面那行是偏移 +4 起的双字,下面那行是偏移 +0 起的双字。上一张彩色图就是照着它重绘的,位号完全一致。
记录和讲解一律以 Figure 3-8 为准。但要注意,手册图是按位号画的,调试器 db 读出来是按小端字节顺序排的,这两种读法必须交叉验证,不能混成一种。本文第五节会把同一条描述符用两种顺序各走一遍。
看图 1 你一定会问:段基址明明是一个连续的 32 位数,为什么在描述符里被劈成 [15:0]、[23:16]、[31:24] 三段,中间还夹着别的字段?段界限也一样,被劈成 [15:0] 和 [19:16]。
这不是设计美学问题,是兼容性的账。
80286 的描述符也是 8 个字节,但它只用到前 6 个:24 位段基址、16 位段界限、一个访问权限字节。最后两个字节是保留的,规定必须写 0。
到了 80386,基址要扩到 32 位、界限要扩到 20 位,还得塞进一组新的标志位。386 不能把描述符改成 12 字节——那样 286 时代所有已经写好的描述符表都得重来。它唯一能做的,就是把那两个一直空着的字节拿出来见缝插针:
G、D/B、AVL 塞进字节 6 的高半字节,还剩一位空着于是就有了图上这种碎法。低 6 个字节的布局和 286 保持一致,新东西全挤在后两个字节里。
那剩下的那一位空位后来怎么样了?它一直空到 64 位时代,才被启用成 L 位——本文第四节会讲到它。
出处说明: 286 描述符只用前 6 字节这条史料来自 Intel 80286 程序员参考手册,当前 SDM 已不再收录。当前手册只能反向印证:字节 6 用作
G / D-B / L / AVL + Limit[19:16]、字节 7 用作Base[31:24],正好就是 286 空着的那两个字节。
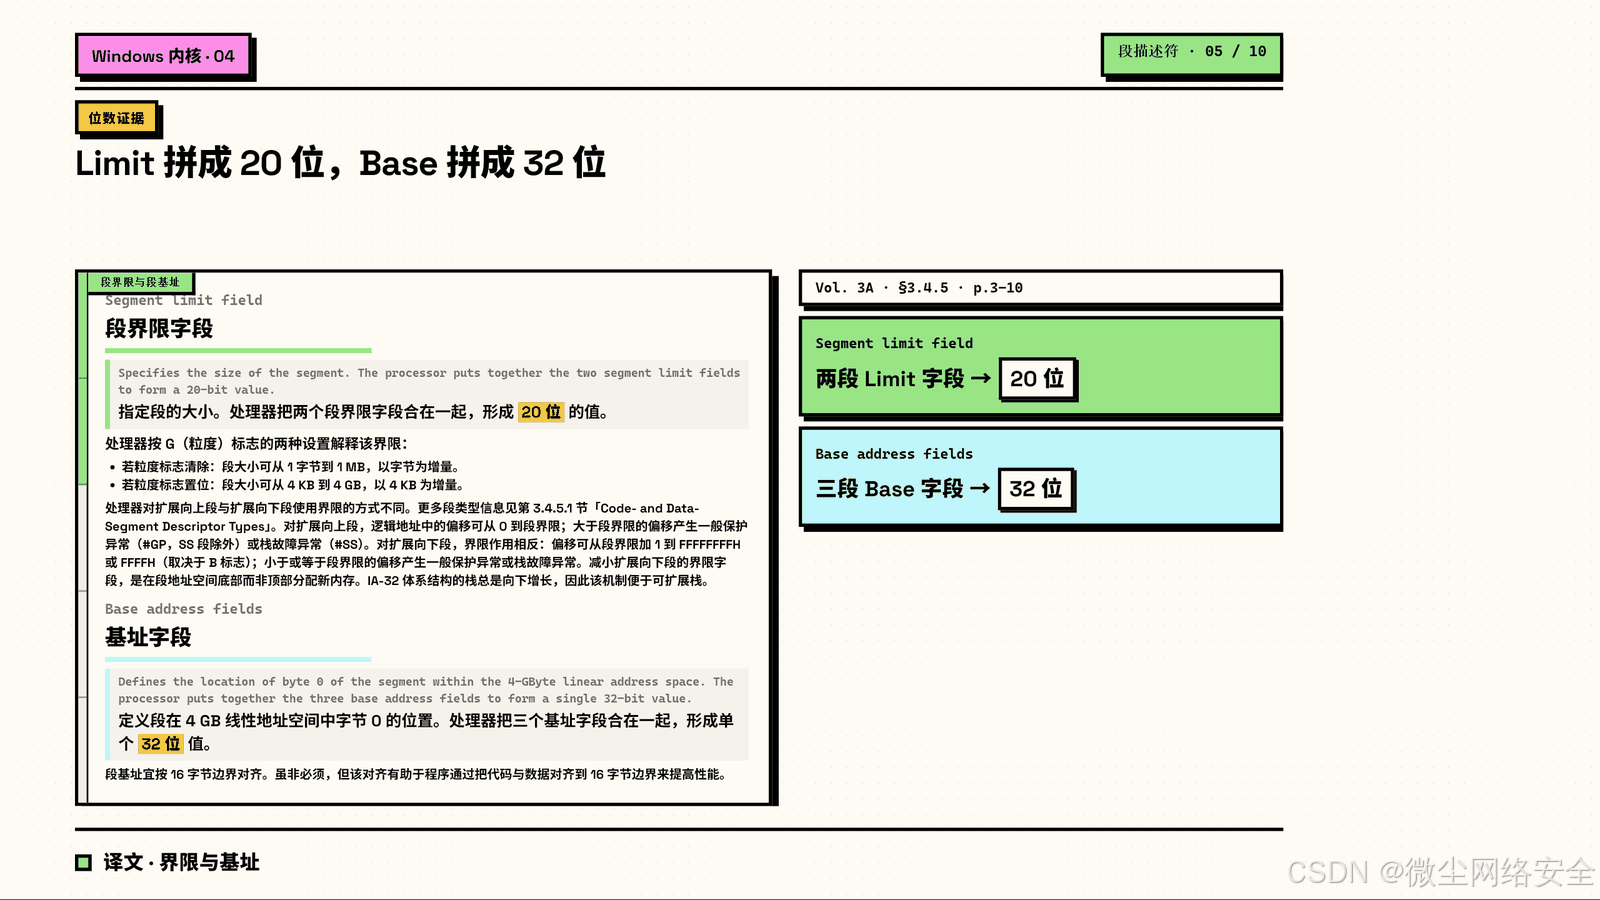
图 3:Vol. 3A §3.4.5 中 Segment limit field 与 Base address fields 两段原文(印刷页 3-10)与中文对照。手册明确写了"处理器把两个段界限字段合在一起,形成一个 20 位的值"和"处理器把三个基址字段合在一起,形成单个 32 位的值"。
原文这两句是本文所有"20 位""32 位"说法的直接依据:
The processor puts together the two segment limit fields to form a 20-bit value.
Defines the location of byte 0 of the segment within the 4-GByte linear address space. The processor puts together the three base address fields to form a single 32-bit value.
同一段还顺带交代了段基址的对齐建议:不强制要求,但对齐到 16 字节边界有助于性能。
描述符 bit 47:40 这一个字节,装了四个字段:P、DPL、S、Type。本文不按位号从高到低念一遍,而是按处理器实际使用它们的顺序讲。原因在 3.2 节会说清楚——其中有一处是硬依赖,顺序反了根本讲不通。
把处理器想成一个门卫,每次程序要用某个段,它按这个顺序盘问:
PSTypeDPLP 是 present。置 1 表示这个段当前可用;清 0 表示明确告诉处理器"这条描述符指向的段现在不在内存里"。
关键在出事的时机,它比很多人以为的要早:
If this flag is clear, the processor generates a segment-not-present exception (#NP) when a segment selector that points to the segment descriptor is loaded into a segment register.
——Vol. 3A §3.4.5,印刷页 3-11
也就是说,不是等你去读那块内存才报错,而是把选择子装进段寄存器的那一刻就产生 #NP(段不存在异常,向量 11)。装载动作本身就失败了。
这一位的设计意图是虚拟内存管理。分页机制普及之前,操作系统要把某个段换出到磁盘,必须有办法在段被真正使用之前拿到一次通知——P 就是那个通知点。手册的说法是:它在分页之外,为管理虚拟内存提供了另一种控制手段。
顺带一个有意思的细节:P = 0 时,Intel 专门另画了一张 Figure 3-9,说明这条描述符里除 P、DPL、S、Type 之外的位置全部标为 Available,操作系统可以随便用,比如记录这个段被换到了磁盘的什么位置。房子既然不在,门牌背面就归物业写便条了。
易错点:段描述符里的
P,和页表项里的P,不是同一个开关。 名字都叫"在不在",但一个管段、一个管页,各查各的,不在同一层。
S 只做一件事——分家:
S = 1:应用段,也就是代码段或数据段。本文的主角。S = 0:系统段或门,包括 LDT、TSS、调用门、中断门、陷阱门、任务门。那是另一族对象。S 真正的分量不在它自己,而在它对 Type 的作用。看位图很容易以为 Type 是个独立字段:四位、十六种取值、背一张表就完事。不是的。 手册在 Type field 的说明里写得很直白:
The interpretation of this field depends on whether the descriptor type flag specifies an application (code or data) descriptor or a system descriptor.
——Vol. 3A §3.4.5,印刷页 3-10
Type 那四位本身不携带固定含义,它更像一个四位的密码,而 S 决定你翻哪一本密码本。同样是 0011,用应用段那本翻出来是"可读写的数据段",用系统段那本翻出来完全是另一回事。
所以顺序不能反:先看 S,再解 Type。 这不是讲解偏好,是解码依赖。
x86 和 x64 上这条分家规则完全一样。唯一要补一句:IA-32e 模式下 S = 0 的系统描述符会扩展成 16 字节(占两个表项的空间),包括调用门、IDT 门、LDT 与 TSS 描述符。(Vol. 3A §3.5.2,印刷页 3-16)看到 16 字节的表项,别用"永远 8 字节"一刀切。
S = 1 时,Type 四位这样读(手册按第二个双字的位号写,即 bit 11:8,对应描述符 bit 43:40):
最高位(描述符 bit 43)定生死: 0 是数据段,1 是代码段。
剩下三位,两边的名字完全不一样:
| 段的种类 | bit 42 | bit 41 | bit 40 |
|---|---|---|---|
| 数据段(bit 43 = 0) | E 扩展方向 | W 可写 | A 已访问 |
| 代码段(bit 43 = 1) | C 一致性 | R 可读 | A 已访问 |
各自的含义:
E(数据段):E = 0 是普通的向上扩展段,合法偏移从 0 到段界限;E = 1 是向下扩展段,界限的作用整个反过来——合法偏移变成"段界限 + 1 到 FFFFFFFFH 或 FFFFH",具体取哪个由 B 位决定。这种段主要给可增长的栈用:减小界限值等于在段的底部追加内存,而不是在顶部。W(数据段):0 只读,1 可读写。C(代码段):一致性(conforming)。往一个特权级更高的一致性代码段转移时,执行可以继续用当前的特权级跑;而转移到不同特权级的非一致性代码段会触发 #GP,除非走调用门或任务门。R(代码段):这段代码能不能被当成数据读出来。注意是"能不能读",不是"能不能写"——手册原话是 "In protected mode, code segments are not writable.",保护模式下代码段一律不可写,没有开关。A(两边都有):见下文。E 和 C 占的是同一个位请盯住上面那张表的第一列。数据段的 E 和代码段的 C,占的都是 bit 42(第二双字的 bit 10)。同一个物理位置,在数据段上叫"向下扩展",在代码段上叫"一致性",两个含义之间没有任何关系。
这就像家里的旋钮:装在洗衣机面板上,这一格是"甩干";同样位置的旋钮装到微波炉上,这一格是"解冻"。你不能指着旋钮问"这一格到底什么意思",得先问"这是哪台机器"。而告诉你是哪台机器的,就是 S 加上 Type 的最高位。
S = 1 时 16 种 Type 取值的完整含义(Vol. 3A §3.4.5.1,Table 3-1,印刷页 3-12):
| 十进制 | bit 43 | bit 42 | bit 41 | bit 40 | 类型 | 说明 |
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | Data | 只读 |
| 1 | 0 | 0 | 0 | 1 | Data | 只读,已访问 |
| 2 | 0 | 0 | 1 | 0 | Data | 可读写 |
| 3 | 0 | 0 | 1 | 1 | Data | 可读写,已访问 |
| 4 | 0 | 1 | 0 | 0 | Data | 只读,向下扩展 |
| 5 | 0 | 1 | 0 | 1 | Data | 只读,向下扩展,已访问 |
| 6 | 0 | 1 | 1 | 0 | Data | 可读写,向下扩展 |
| 7 | 0 | 1 | 1 | 1 | Data | 可读写,向下扩展,已访问 |
| 8 | 1 | 0 | 0 | 0 | Code | 只执行 |
| 9 | 1 | 0 | 0 | 1 | Code | 只执行,已访问 |
| 10 | 1 | 0 | 1 | 0 | Code | 可执行可读 |
| 11 | 1 | 0 | 1 | 1 | Code | 可执行可读,已访问 |
| 12 | 1 | 1 | 0 | 0 | Code | 只执行,一致性 |
| 13 | 1 | 1 | 0 | 1 | Code | 只执行,一致性,已访问 |
| 14 | 1 | 1 | 1 | 0 | Code | 可执行可读,一致性 |
| 15 | 1 | 1 | 1 | 1 | Code | 可执行可读,一致性,已访问 |
加粗那一行就是本文第五节将在真机上读到的值。
A 位:访问痕迹,不是权限开关A(accessed)不是权限位。处理器每次把这个段的选择子装进段寄存器,就顺手把 A 置成 1,一直保持到操作系统显式清零。这一位既能用于虚拟内存管理,也能用于调试。
它背后有个真实的坑,手册专门写了:如果把描述符表放在只读的 ROM 里,处理器想去盖这个"来过"的章却盖不上,就可能陷入死循环。Intel 给的建议是——刻进 ROM 之前先把所有描述符的 A 位置好,另外去掉那些会尝试修改 ROM 中描述符的系统代码。(Vol. 3A §3.4.5.1,印刷页 3-13)
Stack segments are data segments which must be read/write segments. Loading the SS register with a segment selector for a nonwritable data segment generates a general-protection exception (#GP).
——Vol. 3A §3.4.5.1,印刷页 3-12
SS 里装的必须是可读写的数据段。装一个只读数据段或者代码段的选择子进去,处理器直接给 #GP,连试都不让你试。
Type 说的是"这段东西允许什么操作",DPL 说的是"什么身份的人才能来做这些操作"。
DPL 两位,取值 0 到 3,0 最高,3 最低。这个方向经常被记反:数字越小,权力越大。
本文只把三个容易混的名字分清楚,完整的比较规则留给特权级那一篇:
| 名字 | 全称 | 挂在哪 | 表示什么 |
|---|---|---|---|
DPL | Descriptor Privilege Level | 描述符上 | 这个段自己的门槛 |
CPL | Current Privilege Level | 当前 CS 上 | 现在跑在什么特权级 |
RPL | Requested Privilege Level | 选择子低 2 位 | 这次请求自称的身份 |
违反了会怎样?#GP,一般保护异常。这是保护模式里最常见的一个异常。
补充一条常被问到的:特权高的可以访问特权低的数据段,反过来不行。 所以内核代码(CPL = 0)读一个 DPL = 3 的数据段没有问题。
如果你想在代码里读某个选择子的访问权限,不必自己去 GDT 里扒字节,LAR(Load Access Rights)指令会把描述符第二个双字里的权限字段读到通用寄存器。
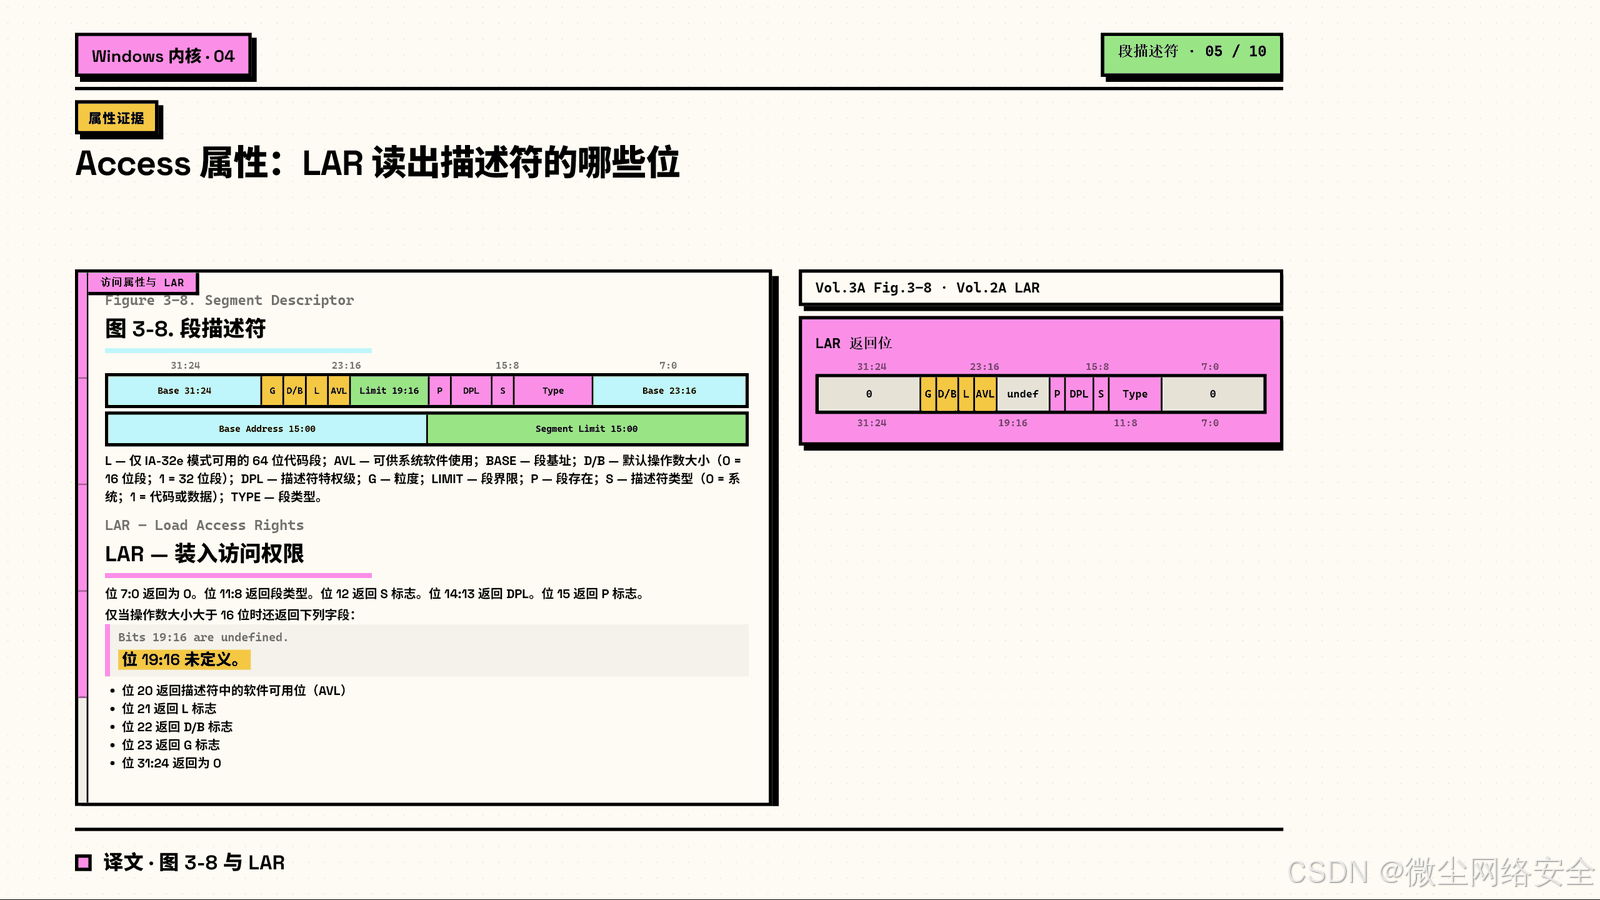
图 4:左边是 Figure 3-8 的彩色重绘,右边是 LAR 返回值的位布局。可以看到 LAR 返回的其实就是描述符第二个双字的权限相关位,Base 和 Limit 全被抹掉。
LAR 返回值的位分配(Vol. 2A,LAR—Load Access Rights,印刷页 3-533):
| 返回值位 | 内容 |
|---|---|
| 7:0 | 恒为 0 |
| 11:8 | 段类型 Type |
| 12 | S 标志 |
| 14:13 | DPL |
| 15 | P 标志 |
| 19:16 | 未定义(仅操作数宽度 > 16 位时返回) |
| 20 | 软件可用位 AVL |
| 21 | L 标志 |
| 22 | D/B 标志 |
| 23 | G 标志 |
| 31:24 | 恒为 0 |
注意 bit 19:16 手册明确写的是 undefined,不要拿它当 Limit[19:16] 用。另外 LAR 只能在保护模式和 IA-32e 模式下执行,且会先做一系列检查(选择子非空、在表界限内、类型对该指令合法、对当前 CPL 可见),检查不过就清 ZF 且不写目标寄存器。
描述符 bit 55:52 这四位。它们的讲解顺序正好和位号顺序一致,可以顺着位图从左往右走。
这是整条描述符里最值得讲的一处工程取舍。先问一个前面故意没答的问题:段界限为什么是 20 位?
32 位、16 位、8 位都很顺口,20 位是从哪冒出来的?
答案是:它是被挤出来的。
一条描述符总共 8 字节,也就是 64 位,这个总额是固定的、加不了。把账摊开看:
| 字段 | 位宽 | 为什么是这个数 |
|---|---|---|
| 段基址 Base | 32 | 要能指到 4 GB 线性空间里的任何一个字节,少不了 |
| 访问属性 Access | 8 | P 1 + DPL 2 + S 1 + Type 4 |
| 标志位 Flags | 4 | G + D/B + L + AVL |
| 段界限 Limit | 20 | 64 − 32 − 8 − 4 |
| 合计 | 64 | 一个 bit 都不剩 |
32 + 20 + 8 + 4 = 64。严丝合缝。
所以 20 位不是被设计出来的,是预算花完之后剩下的那条缝。就像搬家:箱子容积固定,大件先塞进去,最后那条缝有多大,就只能装多大的东西。
这个算式是教学上的反推,不是手册里的因果。 Intel 只给了结果(Base 32 位、Limit 20 位),没有写"因为基址拿走 32 位所以界限只剩 20 位"。这条推演在理解上非常好用,但别说成"手册里说"。
20 位能表示的最大值是 0xFFFFF。按字节算,一个段最大 1 MB。可 386 是一颗 32 位处理器,线性地址空间 4 GB。一个段最多 1 MB,那 4 GB 得靠四千多个段拼起来——这显然说不过去。
Intel 的解法就是 G 位(bit 55),粒度位。它不去动界限的位数,它去动尺子的刻度:
Determines the scaling of the segment limit field. When the granularity flag is clear, the segment limit is interpreted in byte units; when flag is set, the segment limit is interpreted in 4-KByte units.
——Vol. 3A §3.4.5,印刷页 3-11
G | 界限单位 | 段大小范围 | 递增步长 |
|---|---|---|---|
| 0 | 字节 | 1 字节 ~ 1 MB | 1 字节 |
| 1 | 4 KB | 4 KB ~ 4 GB | 4 KB |
4 GB 是怎么算出来的:(0xFFFFF + 1) × 4096 = 1048576 × 4096 = 4294967296 字节,正好 4 GB。一个字节都不多,一个字节都不少。
这就是拿精度换范围。同一把尺子,刻度从毫米改成米,能量的东西一下长了一千倍,代价是量不出零头。量房子很好用,量指甲盖就不行了。
代价具体是什么?G = 1 时段的大小只能是 4 KB 的整数倍。你想要一个刚好 5000 字节的段?做不到,只能给两页 8 KB。要精确到字节就得 G = 0,但那样最大只能到 1 MB。
G = 1 的机制:按手册口径写这里有个流行说法必须纠正。网上(包括不少中文教材)常说"G = 1 时硬件把段界限的低 12 位自动填 1"。结论是对的,机制说法不准。 手册的原话是从比较的角度写的:
When the granularity flag is set, the twelve least significant bits of an offset are not tested when checking the offset against the segment limit. For example, when the granularity flag is set, a limit of 0 results in valid offsets from 0 to 4095.
——Vol. 3A §3.4.5,印刷页 3-11 至 3-12
也就是说,处理器拿偏移和界限做比较时,偏移的低 12 位不参与比较。手册自己举的例子最直白:G = 1、界限写 0,合法偏移是 0 到 4095,整整一页。
两种说法算出来的有效上界是一样的:
有效上界 = 段界限 × 4096 + 4095

G=1, Limit=0x00000  ->  0 × 4096 + 4095      = 0x00000FFF   (4 KB)
G=1, Limit=0xFFFFF  ->  0xFFFFF × 4096 + 4095 = 0xFFFFFFFF   (4 GB)
推论:G = 1 的段,段尾永远落在某个 4 KB 边界的最后一个字节上,不可能停在中间。
还有一条容易忽略的:G 只影响界限,不影响基址。手册专门加了一句括号——"This flag does not affect the granularity of the base address; it is always byte granular.",段基址永远是字节粒度。
对向上扩展段,合法偏移是 0 到段界限;超过界限,一般段触发 #GP,SS 段触发 #SS(栈段异常)。向下扩展段的判据反过来:小于等于段界限的偏移才触发异常。(Vol. 3A §3.4.5,印刷页 3-10)
名字里带斜杠本身就是提示:它在不同类型的段上是不同的岗位。 手册把三种情况分开写(Vol. 3A §3.4.5,印刷页 3-11):
| 装在哪种段上 | 叫什么 | 管什么 | 置 1 | 清 0 |
|---|---|---|---|---|
| 可执行代码段 | D | 默认操作数与地址大小 | 32 位地址、32/8 位操作数 | 16 位地址、16/8 位操作数 |
栈段(SS 指向的数据段) | B(big) | 隐式压栈出栈用的栈指针宽度 | 用 32 位 ESP | 用 16 位 SP |
| 向下扩展数据段 | B | 段的上界 | FFFFFFFFH(4 GB) | FFFFH(64 KB) |
代码段那一栏还有个补充:指令前缀 66H 可以临时改操作数大小,67H 可以临时改地址大小,但默认值由这一位说了算。
手册另外给了一条工程建议:32 位代码段和数据段这一位应该总是置 1,16 位的置 0。
一个位,三个部门,三张名片。所以读描述符时看到这一位,不要急着说它什么意思,先看清楚这是哪一类段——和 3.3 节 E/C 是同一个套路。
到了 64 位,这一位多了一条硬约束:L = 1 时 D 必须为 0。 原因见下一节。
L 就是 2.3 节里 386 留下的那个空位,到 64 位时代才被启用。手册的定义(Vol. 3A §3.4.5,印刷页 3-12):
In IA-32e mode, bit 21 of the second doubleword of the segment descriptor indicates whether a code segment contains native 64-bit code. A value of 1 indicates instructions in this code segment are executed in 64-bit mode. A value of 0 indicates the instructions in this code segment are executed in compatibility mode. If the L-bit is set, then the D-bit must be cleared. Bit 21 is not used outside IA-32e mode (or for data segments).
翻成一句关键结论:"我这台机器是 64 位 Windows"和"我这段代码按 64 位规则执行"是两件事。 真正决定的是当前代码段描述符里的 L 和 D:
L | D | 执行模式 | 典型场景 |
|---|---|---|---|
| 1 | 0 | 64-bit mode | 原生 x64 代码 |
| 0 | 0 / 1 | compatibility mode | WOW64 里的 32 位程序 |
这也解释了 L = 1 时 D 必须清零的原因:进入 64 位模式后,操作数大小已经由 64 位模式自己的规则接管,D 再声明一遍就是自相矛盾。
两条边界要划清楚:
L 只对代码段有这层含义。 不要讲成"把数据段的 L 置 1,它就变成 64 位数据段"——手册明写了 bit 21 在数据段上不使用。L 打开什么东西。手册还提示了一个反向约束:因为当前 CS 的 L 位置 1 时尝试激活 IA-32e 模式会出错,所以在 IA-32e 模式之外运行的软件应该避免从设置了 L 位的描述符装载 CS。
手册对它的描述只有一句话:
Bit 20 of the second doubleword of the segment descriptor is available for use by system software.
——Vol. 3A §3.4.5,印刷页 3-12
就这么一句,没有下文。它不是权限位,不是开关,处理器不检查它,也不关心你在里面写了什么。你可以把它理解成 Intel 装修时在墙上多留的一个插座:这个归你,接什么随你。
它的价值在于让你意识到一件事:这 64 位里,有的位是硬件强制检查的,有的位纯粹是软件的私货。 看到某一位变了,先分清它属于哪一类,再决定要不要紧张。
DS = 0023h 走到 00cff300 0000ffff字段到此讲完。下面换一个方向:不从手册出发,而从一台真机的寄存器出发,一路走到那 8 个字节,再把它读成人话。
证据取自一台 32 位 Windows 10 1803 目标机的内核调试会话。
0023h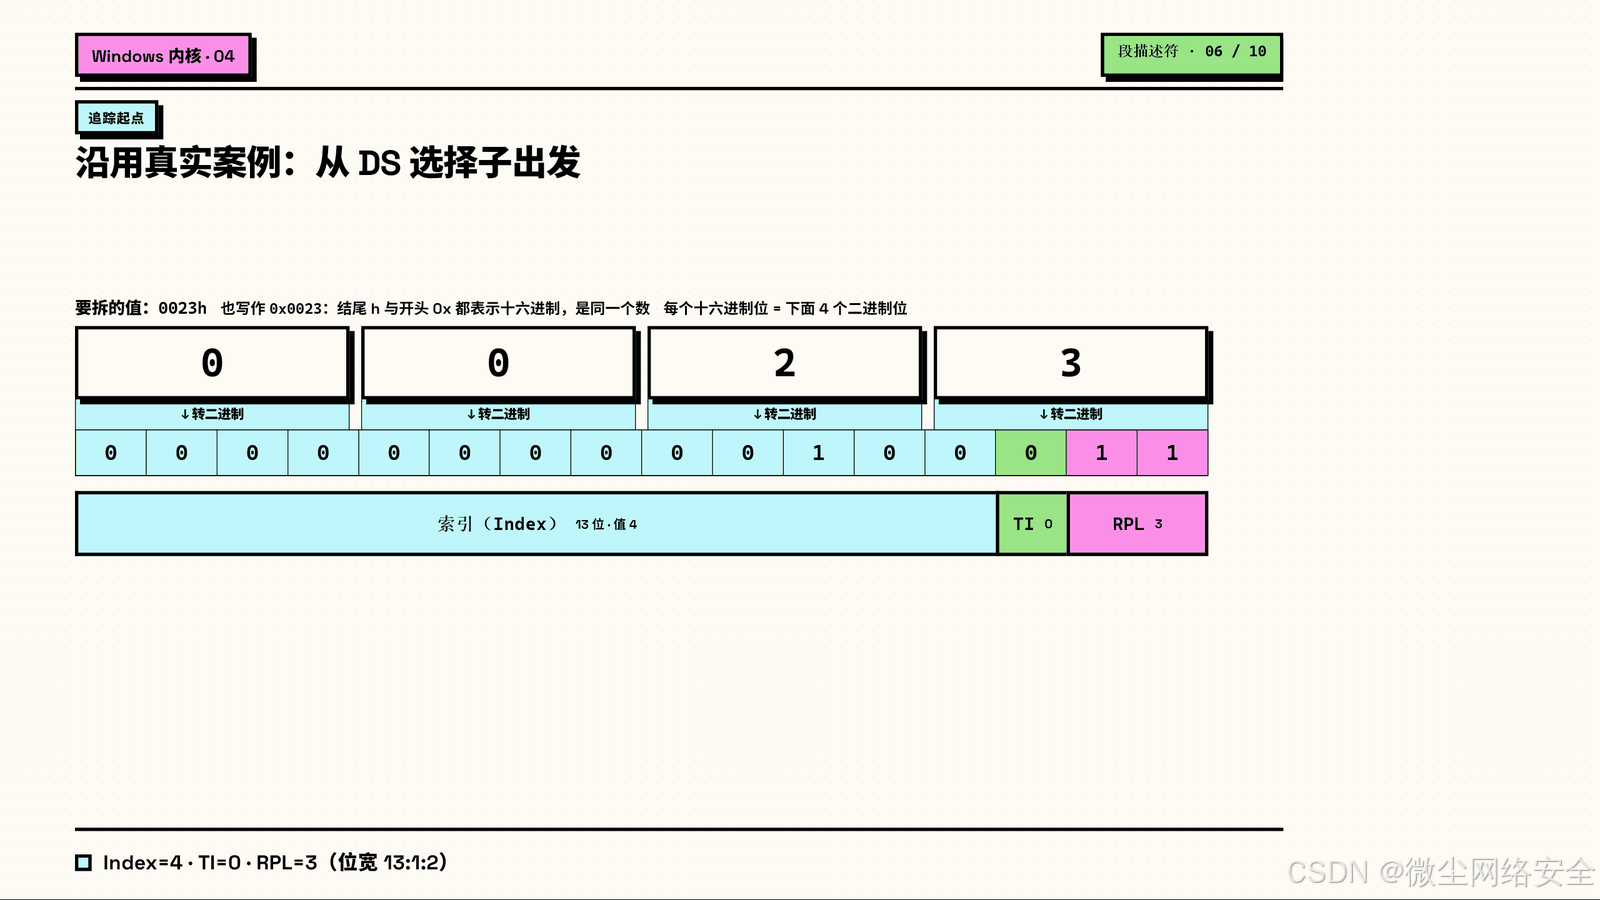
图 5:0023h 按位展开。高 13 位是 Index,bit 2 是 TI,低 2 位是 RPL。
DS = 0x0023 = 0000 0000 0010 0011b

bit 15:3  Index = 0000000000100b = 4
bit 2     TI    = 0                 -> 查 GDT(TI = 1 才是 LDT)
bit 1:0   RPL   = 11b = 3           -> 请求特权级 3
TI = 0 说明查的是 GDT,Index = 4 说明目标是 GDT 的第 4 项(从 0 开始计数,也就是第 5 个槽位)。
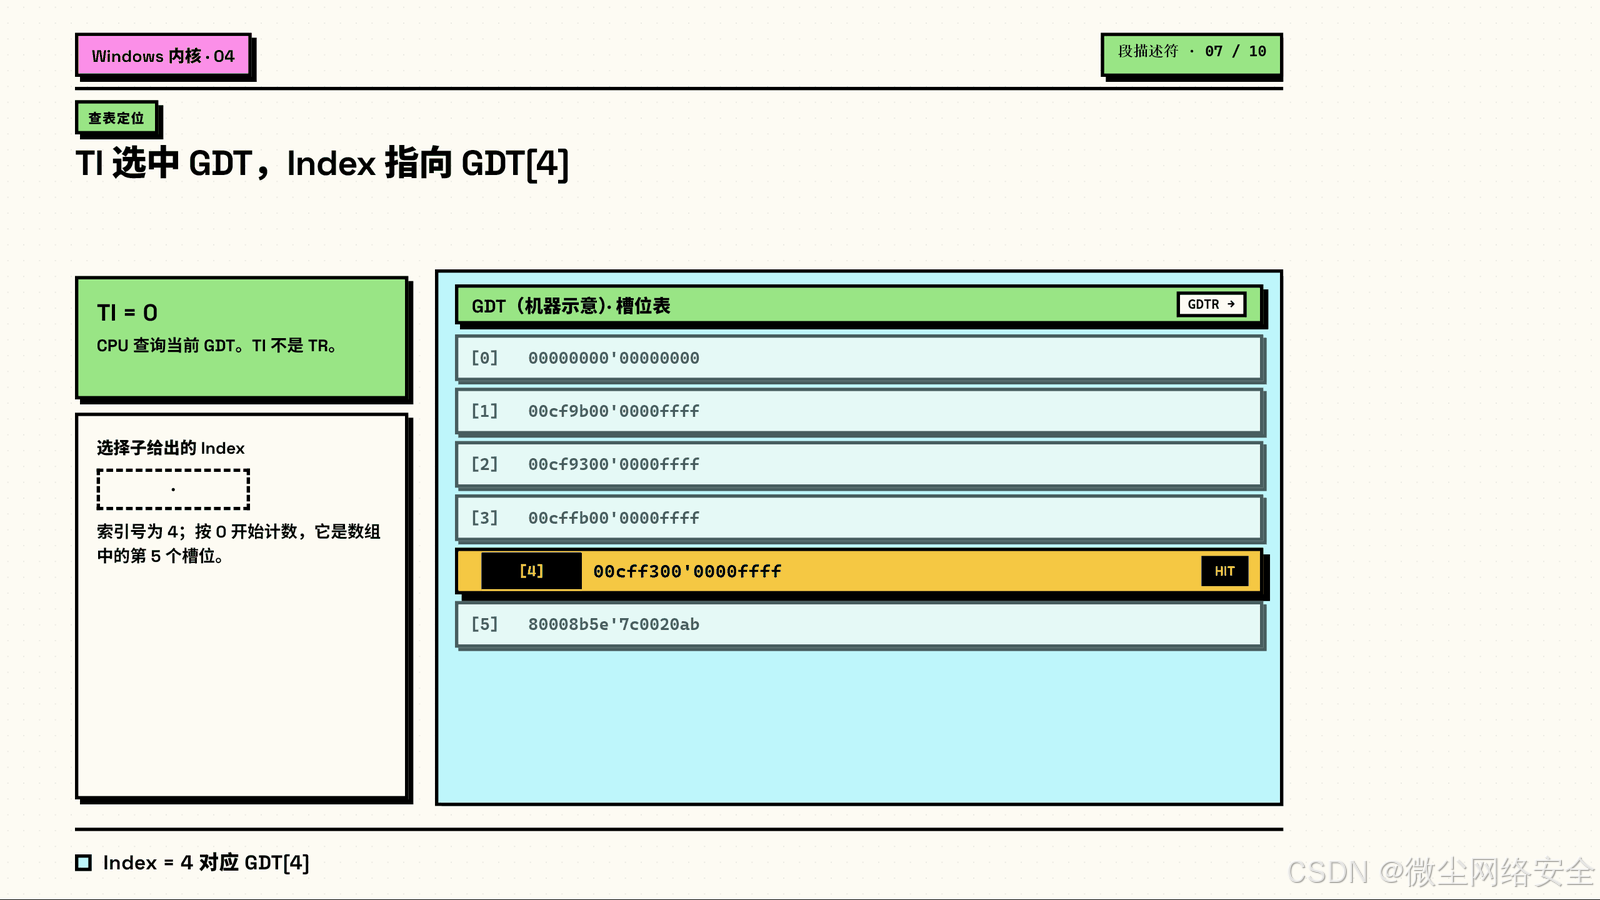
图 6:描述符表按 8 字节一项排列,Index 直接就是数组下标。第 4 项被命中。
表项地址的算法很直接:
描述符地址 = GDT 基址 + Index × 8
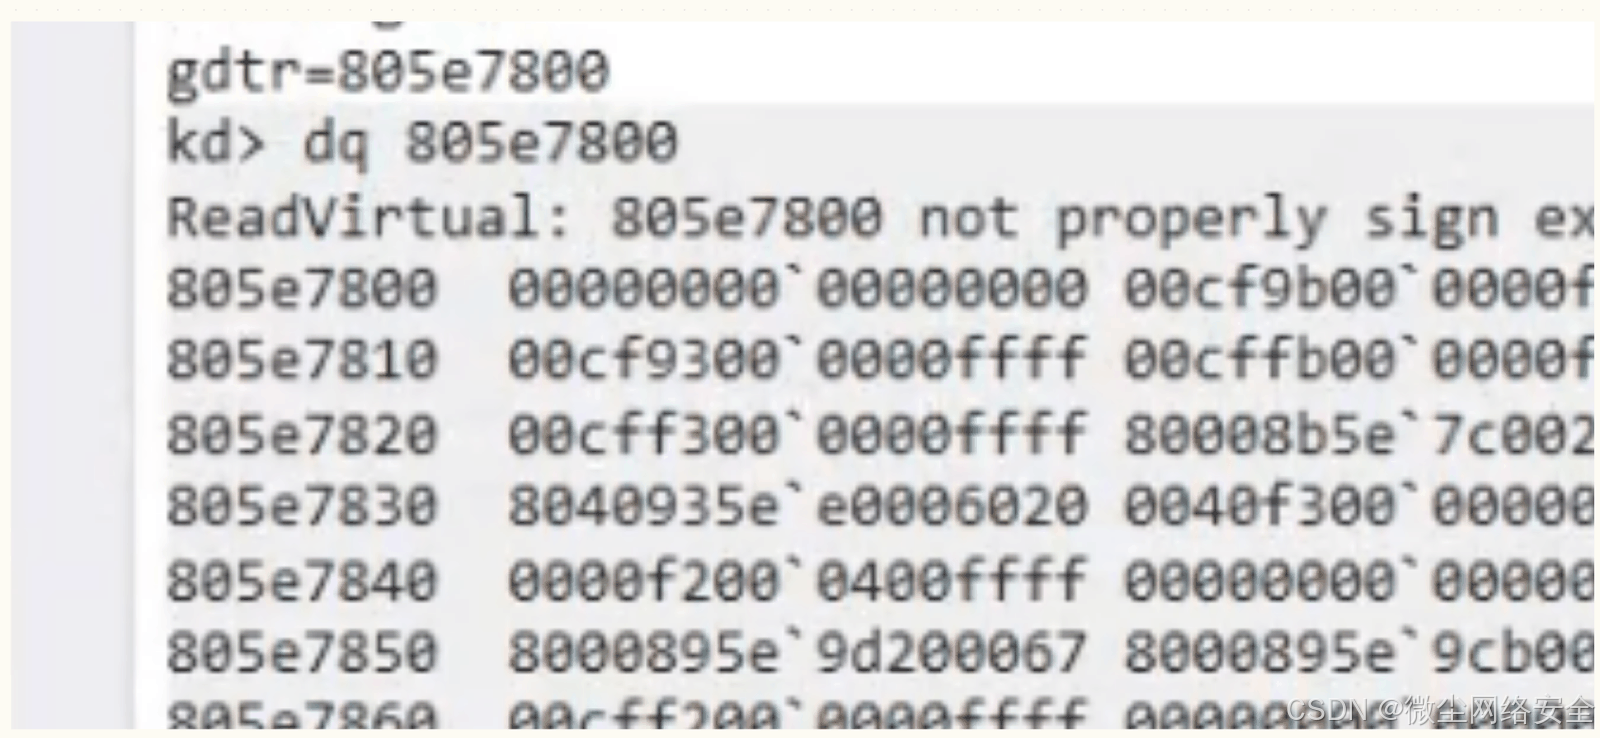
图 7:真机现场。gdtr = 805e7800,dq 805e7800 把 GDT 前几项按 8 字节一组打出来。地址 805e7820 那一行就是 Index = 4 的表项:00cff300`0000ffff。(ReadVirtual: ... not properly sign extended 是 WinDbg 对 32 位目标机地址的常规提示,不影响读数。)
复现命令:
kd> r gdtr
gdtr=805e7800

kd> dq 805e7800 L10
验算表项地址:0x805e7800 + 4 × 8 = 0x805e7800 + 0x20 = 0x805e7820。截图里 805e7820 那一行的第一个 qword 正是 00cff300`0000ffff——和算出来的位置对上了。
WinDbg 也有一步到位的命令:
dg 23会直接把这个选择子对应的描述符解码成一张可读的表(Base、Limit、Type、Pl、Size、Gran、Pres、Long、Flags)。建议的习惯是两条都跑:先dg拿到可读结果,再dq/db把原始字节读出来手算一遍,两边对齐才算真钉死。
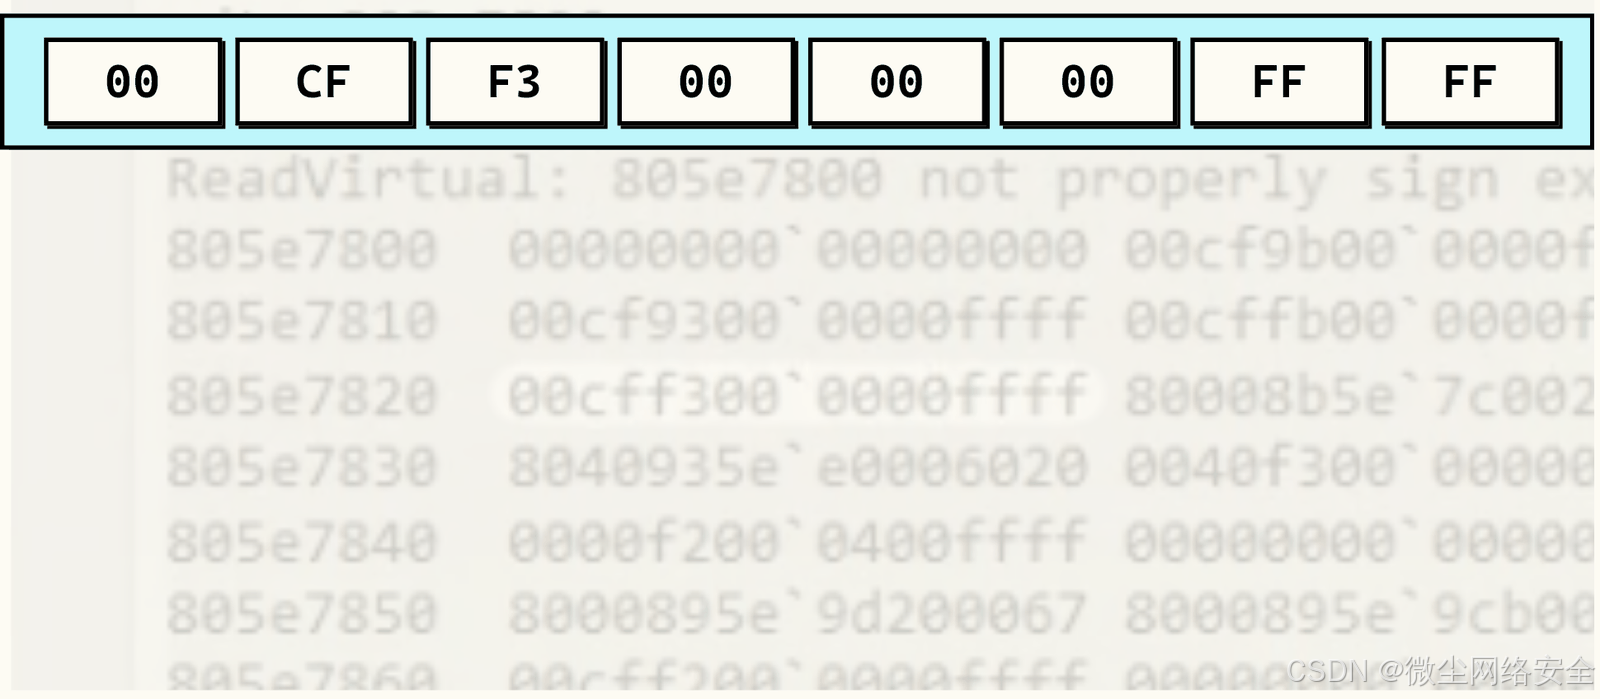
图 8:把 00cff300`0000ffff 按"高位在左"的书写顺序摊成 8 个字节。这是手册图的顺序,不是内存里的字节顺序。
这里必须把两种顺序说清楚,否则后面手算一定会错:
qword 值(书写顺序,高位在左)
  00 CF F3 00 | 00 00 FF FF
   ^  bit63..                  ^ ..bit0

内存里的实际字节(小端,地址递增)
  +0  +1  +2  +3  +4  +5  +6  +7
  FF  FF  00  00  00  F3  CF  00
dq 显示的是值,所以是高位在左;db 显示的是字节,所以是小端顺序。两个视图指的是同一段内存。
记住偏移 +5:Type、S、DPL、P 全挤在这一个字节里(本例是 F3),手算的时候盯它就行。偏移 +6 的高半字节是标志位(本例是 C)。
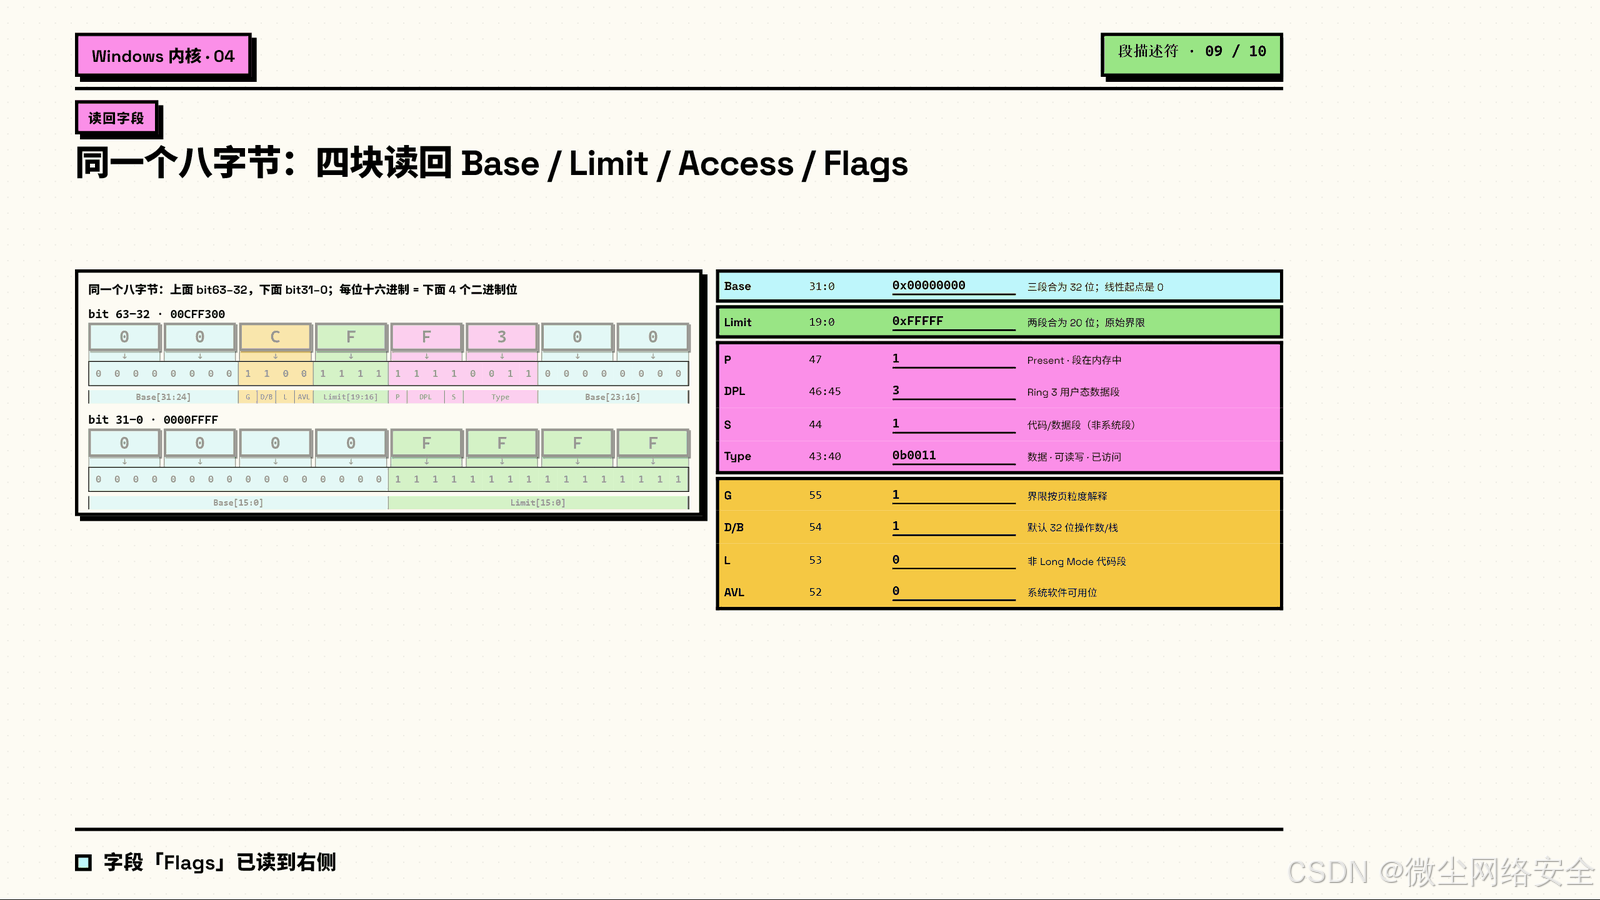
图 9:同一个 8 字节,按 Base / Limit / Access / Flags 四块读出的结果。左边是 hex 与 bit 的逐位对照,右边是每个字段的取值和含义。
先切两半,再按字段切:
高 dword = 00CFF300              低 dword = 0000FFFF

00        -> bit 63:56  Base[31:24] = 0x00
C         -> bit 55:52  Flags       = 1100b
F         -> bit 51:48  Limit[19:16]= 0xF
F3        -> bit 47:40  Access      = 1111 0011b
00        -> bit 39:32  Base[23:16] = 0x00
0000      -> bit 31:16  Base[15:0]  = 0x0000
FFFF      -> bit 15:0   Limit[15:0] = 0xFFFF
拼 Base 和 Limit:
Base  = 0x00 : 0x00 : 0x0000  = 0x00000000
Limit = 0xF  : 0xFFFF         = 0xFFFFF
展开访问属性 F3 = 1111 0011b(切法是 1 | 11 | 1 | 0011,别切错):
| 位 | 字段 | 值 | 读法 |
|---|---|---|---|
| 47 | P | 1 | 段存在 |
| 46:45 | DPL | 11b = 3 | Ring 3,用户态 |
| 44 | S | 1 | 应用段(代码或数据) |
| 43:40 | Type | 0011b | 见下 |
S = 1,所以 Type 查 Table 3-1 的应用段那本:0011b = 十进制 3 = Data Read/Write, accessed。逐位拆开是:bit 43 = 0(数据段)、E = 0(向上扩展)、W = 1(可读写)、A = 1(已被访问过)。
展开标志位 C = 1100b:
| 位 | 字段 | 值 | 读法 |
|---|---|---|---|
| 55 | G | 1 | 界限按 4 KB 计 |
| 54 | D/B | 1 | 32 位段 |
| 53 | L | 0 | 数据段上这一位不承担语义 |
| 52 | AVL | 0 | 系统软件没在这里写东西 |
L = 0 这里要小心:不要把它解释成"这不是 64 位代码段"——它压根就不是代码段,这一位在这儿本来就不使用。
算有效范围:
G = 1, Limit = 0xFFFFF
有效上界 = 0xFFFFF × 4096 + 4095 = 0xFFFFF000 + 0xFFF = 0xFFFFFFFF
Base = 0x00000000
=> 这个段覆盖 0x00000000 ~ 0xFFFFFFFF,整整 4 GB
合成一句话:
一个从线性地址 0 开始、铺满整个 4 GB、用户态可以读写的 32 位数据段。
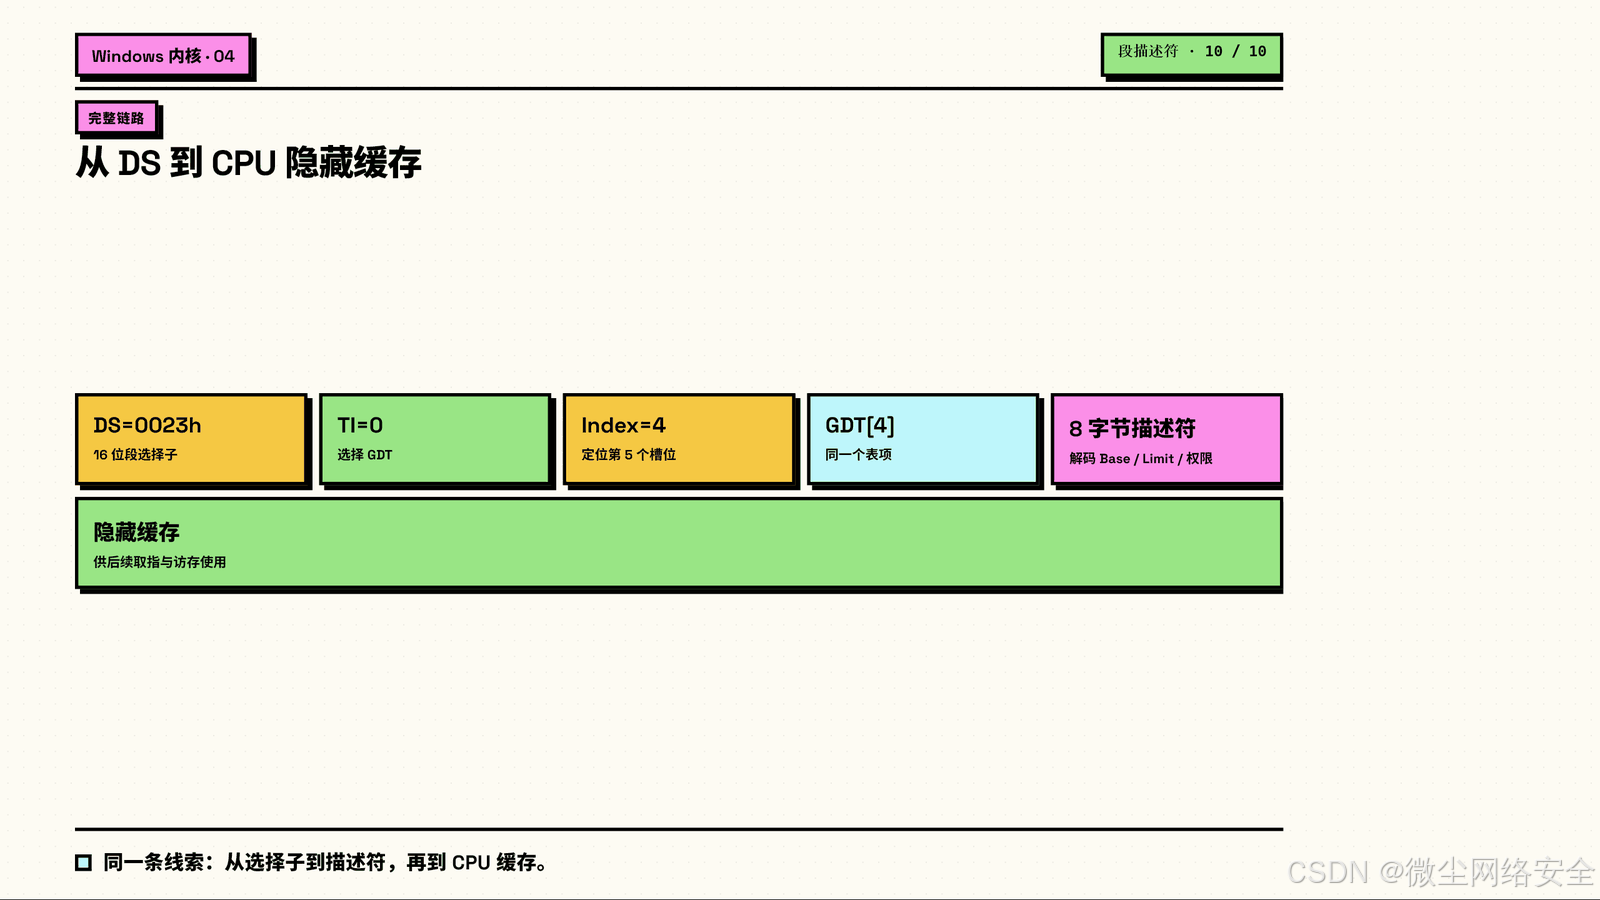
图 10:一条完整链路——选择子 0023h → TI = 0 选 GDT → Index = 4 定位表项 → 8 字节描述符 → 解码结果写进段寄存器隐藏缓存。
上面那句话顺便解释了两件你可能早就习以为常的事:
0xFFFFFFFF 了。所以要说清楚一个常见误解:分段机制一直都在,只是被操作系统配置成了"看起来不存在"。 平坦模型是操作系统的配置选择,不是"CPU 取消了分段"。
别把
0023h当常量背。 这条描述符是 32 位 Windows 的 GDT 第 4 项(用户数据段),在 Windows 7 / 10 / 11 的 32 位环境里基本长这样。但 64 位 Windows 的 GDT 布局不同,用户态数据段的选择子常见是002Bh。上手之前先在自己的目标机上r gdtr+dg走一遍。
同一张描述符,在 32 位保护模式和 IA-32e 模式下,"还管不管事"差别很大。这张表按字段列一遍:
| 字段 | 32 位保护模式 | IA-32e / 64-bit mode |
|---|---|---|
Base | 参与地址计算:线性地址 = Base + 偏移 | CS/DS/ES/SS 的段基址被当作 0;FS/GS 例外,仍作为附加基址寄存器参与计算 |
Limit | 运行时做界限检查,越界 #GP / #SS | 64 位模式下不做运行时界限检查 |
P / DPL / S / Type | 装载选择子时检查 | 装载路径上的检查依然生效 |
G | 决定界限单位 | 字段还在,但界限本身不再参与检查 |
D/B | 默认操作数宽度 / 栈指针宽度 / 上界 | 代码段上与 L 联动;L = 1 时必须为 0 |
L | 不使用 | 决定执行模式:L=1 且 D=0 是 64 位模式,L=0 是兼容模式 |
AVL | 软件私货 | 一样 |
| 描述符长度 | 一律 8 字节 | 应用段仍 8 字节;系统描述符扩为 16 字节 |
手册原文(Vol. 3A §3.2.4,印刷页 3-5):
In 64-bit mode, segmentation is generally (but not completely) disabled, creating a flat 64-bit linear-address space. The processor treats the segment base of CS, DS, ES, SS as zero... The FS and GS segments are exceptions.
Note that the processor does not perform segment limit checks at runtime in 64-bit mode.
关于 FS/GS 还有一条必须知道的:64 位模式下,FS.base 和 GS.base 的隐藏部分被物理映射到 MSR,普通的 MOV to Sreg 只能装载 32 位基址,要写满 64 位得用 WRMSR(或 WRFSBASE / WRGSBASE)。此外 SWAPGS 会把 IA32_KERNEL_GS_BASE 与 GS.base 对调,这是内核入口拿到自己数据结构的常规手法。(Vol. 3A §3.4.4,印刷页 3-9)
所以在 x64 上,不要只从描述符那 32 位基址字段去猜 FS/GS 的真实基址。
写代码或做实验之前,把这几条过一遍:
E 和 C 是同一个位(bit 42),含义完全无关。 读之前先确定这是数据段还是代码段。R 是"能不能读",不是"能不能写"。 保护模式下代码段一律不可写,没有开关。P = 0 的异常发生在装载时刻,不是访问时刻,异常是 #NP 不是 #GP。P ≠ 页表项的 P。 不同层,各查各的。DPL 方向别记反:0 最高,3 最低。G 只作用于界限,不作用于基址。 基址永远字节粒度。G = 1 的机制是"偏移的低 12 位不参与比较",不是"硬件把界限低 12 位填 1"。两种说法结论一样,但只有前者是手册口径。L 位不承担语义,读出 0 不代表任何结论。AVL 不是权限位,硬件完全不看。0xF3 的切法是 1 | 11 | 1 | 0011,手算时最容易切错的就是这里。SS 里必须装可读写数据段,否则 #GP。| 字段 | 位号 | 位宽 | 取值 | 含义 |
|---|---|---|---|---|
Limit[15:0] | 15:0 | 16 | — | 段界限低 16 位 |
Base[15:0] | 31:16 | 16 | — | 段基址低 16 位 |
Base[23:16] | 39:32 | 8 | — | 段基址中 8 位 |
Type | 43:40 | 4 | 见 Table 3-1 | 段类型,S = 1 时按代码/数据表解码 |
S | 44 | 1 | 0 / 1 | 0 = 系统段(另族),1 = 代码或数据段 |
DPL | 46:45 | 2 | 0–3 | 描述符特权级,0 最高 |
P | 47 | 1 | 0 / 1 | 0 → 装载时 #NP |
Limit[19:16] | 51:48 | 4 | — | 段界限高 4 位 |
AVL | 52 | 1 | 0 / 1 | 系统软件可用,硬件不检查 |
L | 53 | 1 | 0 / 1 | 仅代码段、仅 IA-32e:1 = 64 位模式 |
D/B | 54 | 1 | 0 / 1 | 代码段 = D,栈段 = B,向下扩展段 = 上界 |
G | 55 | 1 | 0 / 1 | 0 = 字节粒度,1 = 4 KB 粒度 |
Base[31:24] | 63:56 | 8 | — | 段基址高 8 位 |
关键公式:
线性地址(32 位保护模式)   = Base + 偏移
段有效上界(G = 0)        = Limit
段有效上界(G = 1)        = Limit × 4096 + 4095
描述符地址                 = 描述符表基址 + Index × 8
本文所有结论均对照 Intel SDM 第 091 版核对,页码为印刷页码(不是 PDF 页码):
| 结论 | 出处 |
|---|---|
| 描述符总体格式、字段图 | Vol. 3A §3.4.5,Figure 3-8,p. 3-10 |
两段界限合成 20 位;G=0 → 1 字节~1 MB;G=1 → 4 KB~4 GB | Vol. 3A §3.4.5「Segment limit field」,p. 3-10 |
向上扩展越界 → #GP(SS 为 #SS);向下扩展界限反用,上界随 B 为 FFFFFFFFH 或 FFFFH | Vol. 3A §3.4.5「Segment limit field」,p. 3-10 |
| 三段基址合成 32 位,定义段在 4 GB 线性空间中字节 0 的位置 | Vol. 3A §3.4.5「Base address fields」,p. 3-10 |
Type 的解释依赖描述符类型标志 | Vol. 3A §3.4.5「Type field」,p. 3-10 |
S:0 = 系统段,1 = 代码或数据段 | Vol. 3A §3.4.5「S (descriptor type) flag」,p. 3-11 |
DPL 0~3,0 最高 | Vol. 3A §3.4.5「DPL field」,p. 3-11 |
P=0 时装载选择子即产生 #NP;P=0 的描述符里 Available 区域操作系统可自用 | Vol. 3A §3.4.5「P flag」+ Figure 3-9,p. 3-11 |
D/B 三种身份(代码段 D、栈段 B、向下扩展数据段上界) | Vol. 3A §3.4.5「D/B flag」,p. 3-11 |
G 只影响界限不影响基址;G=1 时偏移的低 12 位不参与与界限的比较;例:G=1、界限 0 → 合法偏移 0~4095 | Vol. 3A §3.4.5「G (granularity) flag」,p. 3-11 ~ 3-12 |
L:IA-32e 下第二个双字的 bit 21;L=1 则 D 必须清零;IA-32e 之外与数据段上不使用 | Vol. 3A §3.4.5「L flag」,p. 3-12 |
AVL:第二个双字的 bit 20 供系统软件使用 | Vol. 3A §3.4.5「Available and reserved bits」,p. 3-12 |
S=1 时 Type 最高位分代码/数据;数据段低三位 = A/W/E,代码段低三位 = A/R/C;类型表 | Vol. 3A §3.4.5.1 + Table 3-1,p. 3-12 ~ 3-13 |
栈段必须是可读写数据段,否则 #GP | Vol. 3A §3.4.5.1,p. 3-12 |
| 保护模式下代码段不可写;一致性代码段可保持当前特权级 | Vol. 3A §3.4.5.1,p. 3-13 |
A 位由处理器在装载选择子时置位;ROM 中的描述符应预先置好 A,否则可能死循环 | Vol. 3A §3.4.5.1,p. 3-13 |
| 描述符表最多 8192 项;IA-32e 下系统描述符扩为 16 字节(调用门、IDT 门、LDT/TSS) | Vol. 3A §3.5.2,p. 3-16 |
64 位模式下分段基本关闭,CS/DS/ES/SS 基址按 0 处理,FS/GS 例外;不做运行时界限检查 | Vol. 3A §3.2.4,p. 3-5 |
FS.base/GS.base 映射到 MSR,SWAPGS 与 IA32_KERNEL_GS_BASE | Vol. 3A §3.4.4,p. 3-9 |
LAR 返回位布局 | Vol. 2A,LAR—Load Access Rights,p. 3-533 |
P),再问是哪一族(S),再问能干什么(Type),再问谁能碰(DPL),最后才是有多大(G)和按什么规矩跑(D/B、L)。其中 S 必须在 Type 之前,这不是编排偏好,是解码依赖。E 和代码段的 C 占同一个 bit 42,D/B 在三种段上有三个岗位。读描述符之前,永远先确定这是哪一类段。G 位,是这条描述符里最典型的一次工程取舍。 64 位预算摆在那儿,基址拿走 32,属性和标志拿走 12,剩下 20 位再省也表示不了 4 GB,于是 Intel 换了一把尺子。你在系统底层遇到的很多"奇怪设计",翻到底都是这种账。这篇属于「Windows 内核 · 保护模式」系列。前面几篇分别讲了段寄存器(可见部分与隐藏缓存)、段选择子(Index / TI / RPL)